2016年,AlphaGo让世界记住了"自我对弈"这个词。两个一模一样的神经网络互相下棋,越下越强,最后强到能吊打人类冠军。
但如果你以为这套把戏能直接搬到语言模型身上,那就想简单了。
围棋有一个天然的好处:规则永远不变,棋盘永远是19乘19,输赢永远由棋盘上的黑白子说了算。可语言模型要处理的是数学题、代码题、还有需要连续好几十步操作的工具调用任务。如果只是让模型自己出题自己做,很快就会撞上一堵墙,这堵墙有个专门的名字,叫"隐形皮带"。
**隐形皮带指的是:一个模型出的题目,永远不会比它自己脑子里已经装着的知识更难。**
这就好比让一个只会煮泡面的人去写菜谱大全,他写出来的菜谱翻来覆去也就是那几种泡面的花样,加不加蛋、加不加葱、水放多少,他写不出佛跳墙,因为他压根不知道佛跳墙是什么。自我对弈在语言模型这里最大的风险,就是模型给自己出的题目会越来越单调、越来越简单,最后所有的题目看起来都长得差不多,这种现象论文里管它叫"模式坍缩"。
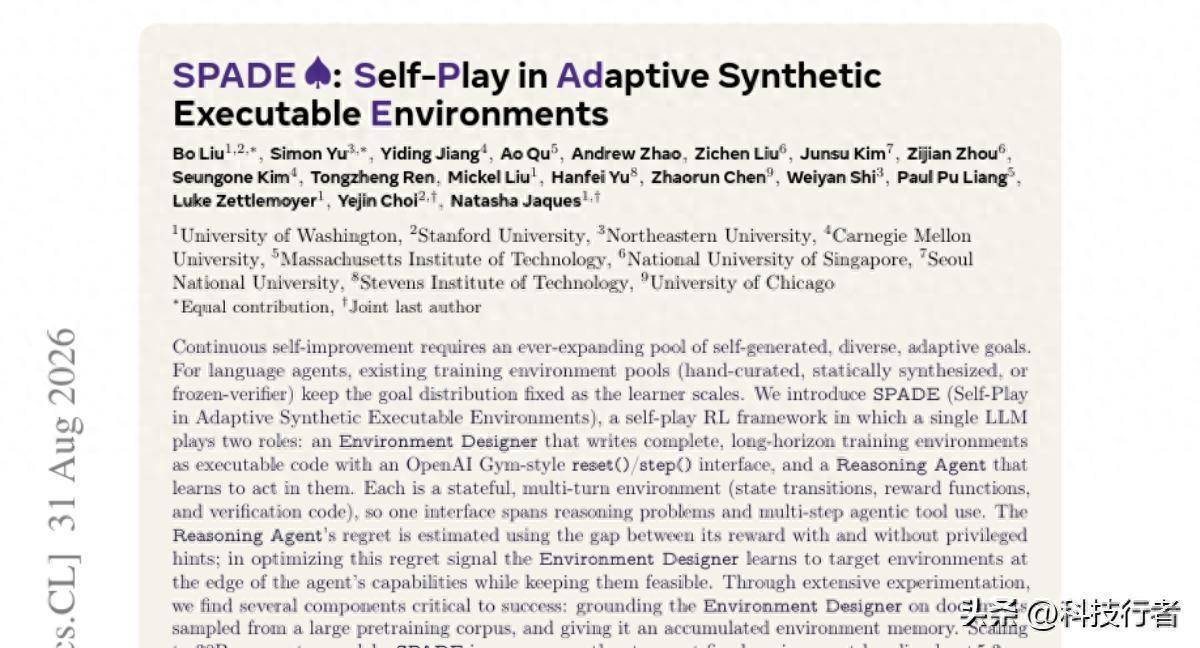
华盛顿大学、卡内基梅隆、MIT等多所高校和机构的研究者联手,在2026年这篇论文里,给出了一个解法。这个解法有一个挺有意思的名字,叫SPADE
**SPADE:全称是Self-Play in Adaptive Synthetic Executable Environments,翻译过来是"在自适应合成可执行环境中的自我对弈"。**
这套系统的核心想法说起来不复杂,用一个模型同时扮演两个角色。一个角色叫"环境设计师",专门负责写训练环境的代码,这些环境不是随便写写的问答题,而是完整的、可以运行的Python程序,带着状态、带着规则、带着怎么判断对错的逻辑。另一个角色叫"推理智能体",专门负责去解这些环境设计师造出来的题。
这两个角色其实是同一套参数,同一个大脑,只是穿上了不同的"工作服"。
为什么代码是关键:一份说明书和一台真机器的区别
先说清楚一件事:SPADE里的"环境",跟我们平时说的"出一道题"完全不是一个量级的东西。
如果你让一个模型写一道数学题,那顶多就是一段文字加一个标准答案,做对了给1分,做错了给0分,事情就这么结束了。但SPADE让环境设计师写的是一个完整的程序,这个程序遵循一套叫做
**Gym风格接口:一种在强化学习领域被广泛采用的编程规范,最早由OpenAI提出。它规定任何一个训练环境都要提供reset()和step()两个函数,reset()负责把环境恢复到初始状态,step()负责接收智能体的一个动作,然后返回新的状态、奖励、以及这一局是否结束。**
的程序。这意味着什么?意味着环境设计师不是在写一道题,而是在搭建一整个小世界,这个世界里有隐藏的状态(比如一个法律纠纷案例里,爷爷到底立没立遗嘱,这个信息一开始藏着,主角得靠一步步询问才能挖出来),有多轮交互(不是一锤子买卖,而是像玩文字冒险游戏一样,你每做一个动作,世界就给你一点反馈,你根据反馈调整下一步),还有一套写在代码里、跑起来就能判断对错的验证逻辑。
这里必须打个比方,才能真正说清楚这个设计的分量。
想象你要培养一个厨师。第一种做法是给他一堆菜谱,菜谱上写着"红烧肉需要五花肉、酱油、糖",他背下来就算过关。第二种做法是直接把他扔进一个真实的厨房,锅碗瓢盆俱全,食材新鲜但会变质,火候需要现场判断,客人还会因为菜咸了淡了而现场反馈。
第一种做法培养出来的是"背菜谱的人",第二种做法培养出来的才是"真正会做菜的人"。如果SPADE只是让环境设计师写"一道数学题加一个答案",那推理智能体学到的顶多是解题技巧的堆砌,但因为环境设计师写的是完整的可执行程序,推理智能体在里面练习的是真正的、需要连续判断和调整的解决问题的能力。这也是为什么论文特别强调,这套系统能同时覆盖单轮推理任务(比如证明一道数学题)和多轮工具调用任务(比如连续操作好几个API接口才能完成一个客服工单),因为它们本质上都能写成同一种带
reset()
step()
的程序。
怎么判断一道题出得好不好:用"提示"来测量差距
光有能写代码的环境设计师还不够,最难的问题其实是:怎么知道环境设计师出的题,出得好不好?
太简单的题,推理智能体一学就会,没什么锻炼价值。太难的题,推理智能体怎么都做不出来,同样白费功夫。真正有价值的题,应该卡在推理智能体"踮起脚尖刚好能够到"的那个难度上。
这在教育学里其实早有说法股票配资资讯门户,叫"最近发展区
亿腾证劵提示:文章来自网络,不代表本站观点。
- 上一篇:配资网大全 奥迪“曾是”奔驰旗下品牌?
- 下一篇:没有了
相关文章


沪深京指数
热点资讯


